Abstract
L’espressione “intelligenza artificiale” viene utilizzata per indicare sistemi molto differenti: modelli linguistici, generatori di immagini, classificatori, sistemi di riconoscimento, modelli previsionali, traduttori automatici e strumenti di ottimizzazione. Riunirli sotto una sola etichetta può far credere che funzionino tutti nello stesso modo e possiedano una forma generale di comprensione. Non è così.
I grandi modelli linguistici, o LLM, generano testo sulla base delle regolarità statistiche apprese durante l’addestramento. I generatori di immagini producono invece nuove composizioni visive mediante modelli addestrati su immagini e descrizioni. Altri sistemi si limitano a classificare, prevedere o individuare anomalie. La capacità di produrre risultati convincenti non garantisce verità, comprensione, affidabilità o rispetto rigoroso delle istruzioni.
Gli strumenti generativi possono essere utili per creare bozze, organizzare informazioni, produrre immagini o esplorare alternative. Presentano però limiti strutturali: possono inventare dati e fonti, confondere elementi simili, modificare dettagli non richiesti, contraddirsi, dichiarare verifiche mai eseguite e non rispettare vincoli già stabiliti. Questi problemi diventano particolarmente gravi quando il sistema può intervenire direttamente su file, infrastrutture, dispositivi o decisioni ad alto impatto.
Esistono inoltre LLM chiusi, modelli con pesi scaricabili e sistemi più propriamente aperti. Alcuni possono essere eseguiti localmente e adattati mediante fine-tuning, ma questa possibilità non li rende deterministici o infallibili.
Parole chiave
Intelligenza artificiale, AI generativa, LLM, modelli linguistici, transformer, generatori di immagini, modelli di diffusione, allucinazioni, fine-tuning, open source, open-weight, affidabilità, controllo umano.
Intelligenza artificiale è un termine generale
L’intelligenza artificiale non identifica una singola tecnologia. È una categoria molto ampia che comprende sistemi progettati per svolgere attività normalmente associate alla percezione, alla classificazione, alla previsione, alla generazione di contenuti o al supporto decisionale.
Sotto la stessa etichetta vengono comunemente raggruppati:
- modelli linguistici;
- generatori di immagini, audio e video;
- riconoscimento vocale;
- sintesi della voce;
- sistemi di visione artificiale;
- classificatori;
- sistemi di raccomandazione;
- rilevamento di anomalie;
- modelli previsionali;
- sistemi di ottimizzazione e controllo.
Questi strumenti possono condividere alcuni metodi matematici o tecniche di apprendimento automatico, ma non svolgono la stessa funzione e non producono lo stesso tipo di risultato.
Definire genericamente tutto come “AI” nasconde quindi differenze fondamentali: un classificatore che riconosce un oggetto, un sistema che genera una fotografia artificiale e un modello che scrive un testo non lavorano nello stesso modo.
Che cosa sono gli LLM
LLM significa Large Language Model, cioè grande modello linguistico.
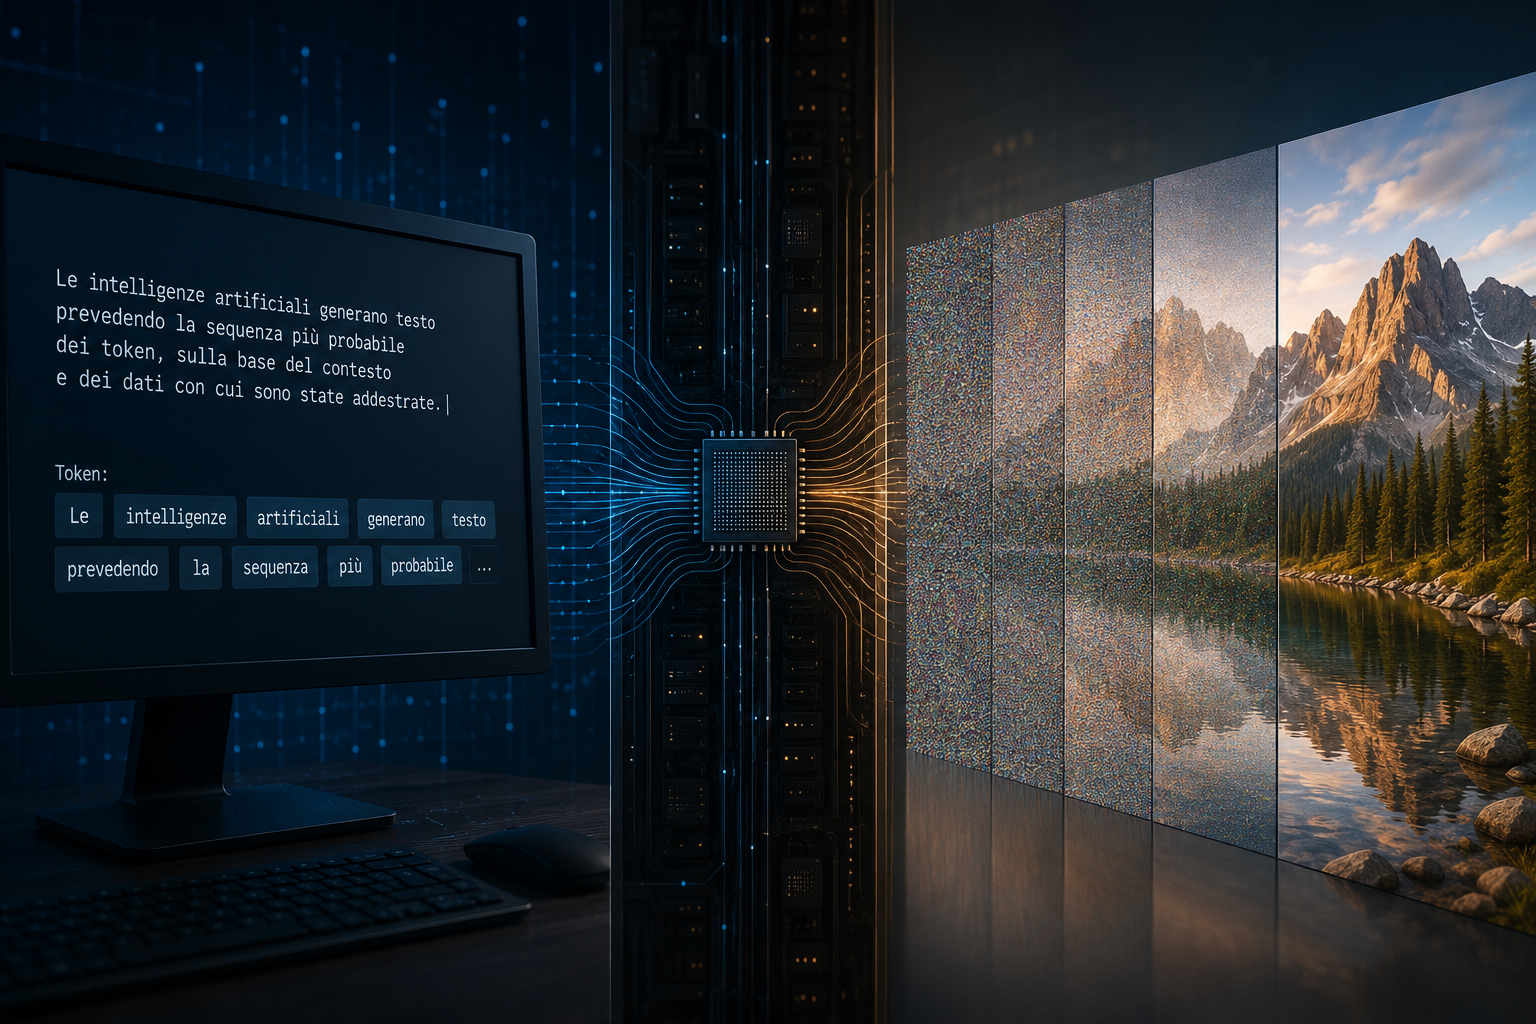
Un LLM viene addestrato su grandi quantità di testo per apprendere relazioni statistiche tra parole, frammenti di parole, simboli e strutture linguistiche. Il testo viene suddiviso in unità chiamate token. Il modello riceve una sequenza di token e calcola una distribuzione di probabilità sui possibili token successivi; il token effettivamente scelto dipende poi dalla strategia di generazione utilizzata.
La risposta viene costruita progressivamente:
testo iniziale
→ suddivisione in token
→ elaborazione del contesto
→ calcolo delle probabilità
→ scelta del token successivo
→ aggiornamento del contesto
→ ripetizione
Gran parte degli LLM moderni deriva dall’architettura Transformer, introdotta nel 2017. Il Transformer utilizza meccanismi di attenzione che permettono al modello di mettere in relazione parti differenti della sequenza elaborata.
Un LLM non cerca necessariamente una frase già esistente e non recupera automaticamente una risposta verificata. Genera una continuazione linguisticamente plausibile sulla base del contesto e dei parametri appresi.
Un LLM non è un motore di ricerca
Un motore di ricerca individua documenti presenti in un indice e restituisce collegamenti o estratti associati a fonti esistenti.
Un LLM, quando opera senza strumenti esterni, produce testo mediante generazione statistica. Può quindi formulare una risposta anche quando non possiede informazioni sufficienti per sostenerla.
Questa differenza spiega perché un modello possa:
- fornire una risposta scorrevole ma falsa;
- inventare una fonte;
- attribuire a una norma una prescrizione inesistente;
- creare un titolo plausibile ma mai approvato;
- descrivere una verifica che non è stata eseguita;
- completare informazioni mancanti con dettagli non richiesti.
Un LLM può essere collegato a motori di ricerca, archivi o strumenti di calcolo. In quel caso dispone di dati esterni, ma deve comunque interpretarli e trasformarli in una risposta. L’accesso a una fonte non elimina automaticamente gli errori di lettura, selezione o sintesi.
Perché sembra comprendere
Un LLM può mantenere il tono, utilizzare terminologia tecnica, costruire ragionamenti ordinati e rispondere in modo coerente al contesto.
Questa capacità produce una forte impressione di comprensione. Tuttavia, la qualità linguistica non dimostra che il modello possieda una rappresentazione corretta del mondo, abbia verificato ciò che afferma o comprenda l’intenzione dell’utente nello stesso senso umano.
Il modello può riprodurre efficacemente la forma di:
- una spiegazione tecnica;
- una dimostrazione;
- una diagnosi;
- una citazione;
- un rapporto di verifica;
- una risposta sicura.
La forma corretta non garantisce che il contenuto sia corretto.
Questa distinzione è particolarmente importante perché un errore espresso con esitazione può essere riconosciuto, mentre un errore formulato in modo preciso e autorevole può essere accettato come vero.
Perché gli LLM inventano
La produzione di informazioni false ma plausibili viene spesso indicata con il termine “allucinazione” o, più precisamente, confabulazione.
Il modello deve generare una continuazione. Quando il contesto non contiene la risposta o i parametri appresi non permettono di ricostruirla correttamente, può comunque produrre una sequenza linguisticamente credibile.
La confabulazione non è necessariamente un malfunzionamento occasionale sovrapposto a un sistema altrimenti deterministico. Deriva dal fatto che lo strumento è progettato per generare testo plausibile, non per garantire automaticamente che ogni frase corrisponda a un fatto verificato.
Il profilo NIST dedicato all’AI generativa identifica le confabulazioni tra i rischi specifici di questi sistemi e raccomanda valutazione, verifica, documentazione e gestione del rischio durante l’intero ciclo di vita.
Perché non rispettano sempre i paletti
Le istruzioni fornite a un LLM non vengono eseguite come istruzioni rigide di un programma tradizionale.
In un programma deterministico, una regola può essere codificata in modo esplicito:
se la classe richiesta è article-image
non utilizzare mai article-media
Un LLM riceve invece una sequenza di testo composta da richiesta, contesto, esempi e istruzioni. Tutti questi elementi contribuiscono alla generazione della risposta.
Quando nel contesto compaiono strutture simili, il modello può selezionare quella statisticamente più associata al compito, anche se non è quella approvata. Può inoltre reinterpretare un vincolo, generalizzarlo, dimenticarne una parte o sostituirlo con uno schema incontrato più frequentemente durante l’addestramento.
Gli errori tipici comprendono:
- modifica di dettagli già stabiliti;
- sostituzione di nomi, titoli o percorsi;
- aggiunta di elementi non richiesti;
- omissione di parti obbligatorie;
- fusione di due template differenti;
- applicazione di una regola corretta al contesto sbagliato;
- mancato confronto finale con il modello fornito.
Il fatto che una regola sia scritta chiaramente riduce il rischio, ma non produce una garanzia assoluta di esecuzione letterale.
Perché cambiano idea tra una risposta e l’altra
Ogni risposta viene generata nuovamente sulla base del contesto disponibile.
Il modello non recupera necessariamente una singola conclusione immutabile. Può produrre valutazioni differenti quando cambiano:
- formulazione della domanda;
- informazioni presenti nel contesto;
- ordine degli esempi;
- priorità attribuita alle istruzioni;
- parametri di generazione;
- versione del modello.
Questo comportamento può essere utile nei compiti creativi, ma è problematico quando l’utente richiede coerenza tecnica, ripetibilità o applicazione identica di uno schema.
Un sistema probabilistico può generare più soluzioni plausibili. Un procedimento tecnico ripetitivo richiede invece che la stessa struttura venga applicata nello stesso modo.
Che cosa sono i generatori di immagini
I generatori di immagini appartengono anch’essi all’AI generativa, ma non sono semplicemente LLM che producono fotografie.
Molti sistemi moderni utilizzano modelli di diffusione. Durante l’addestramento il modello apprende a ricostruire immagini progressivamente degradate dal rumore. Durante la generazione parte da una configurazione rumorosa e la trasforma gradualmente in un’immagine compatibile con la descrizione fornita.
Il testo del prompt viene trasformato in una rappresentazione numerica che guida il processo visivo. Il modello non recupera necessariamente un’immagine completa da un archivio e non disegna gli elementi seguendo un progetto geometrico esplicito.
Il risultato viene costruito sulla base di associazioni apprese tra:
- parole;
- forme;
- oggetti;
- composizione;
- illuminazione;
- prospettiva;
- stile;
- relazioni visive.
Perché un generatore di immagini modifica anche ciò che non è stato richiesto
Quando viene chiesta una modifica, il generatore può dover rigenerare parte dell’immagine.
Non sempre conserva ogni pixel o ogni rapporto geometrico dell’originale. Cerca invece una nuova composizione compatibile con il prompt, con l’immagine di riferimento e con i modelli visivi appresi.
Può quindi:
- cambiare la forma di un oggetto;
- sostituire un componente;
- modificare il numero di elementi;
- alterare scritte e simboli;
- cambiare lo sfondo;
- spostare proporzioni;
- aggiungere dettagli ritenuti visivamente plausibili.
Questo limite è particolarmente evidente quando si richiedono loghi, schemi tecnici, circuiti, testi leggibili o modifiche millimetriche. Il risultato può essere visivamente convincente ma tecnicamente scorretto.
Sistemi commerciali come Leonardo AI possono integrare modelli differenti, strumenti di controllo, modifica e generazione. Il nome del servizio non identifica necessariamente un’unica architettura. Il principio generale resta però distinto da quello di un LLM testuale: l’uscita principale è una rappresentazione visiva, non una sequenza linguistica.
Altri sistemi chiamati AI
Non tutta l’intelligenza artificiale è generativa.
Un classificatore può ricevere un’immagine e assegnarla a una categoria. Un sistema di rilevamento può individuare un difetto, una persona o un veicolo. Un modello previsionale può stimare una quantità futura a partire da serie storiche. Un sistema di raccomandazione può ordinare prodotti o contenuti in base a comportamenti precedenti.
Questi strumenti producono generalmente:
- una classe;
- una probabilità;
- una posizione;
- una previsione;
- un punteggio;
- un’anomalia;
- una decisione tra alternative definite.
Possono comunque sbagliare, ma il tipo di errore è differente da quello di un modello generativo.
Un classificatore può assegnare una categoria errata. Un LLM può invece costruire un’intera spiegazione falsa, completa di dettagli, cause e riferimenti plausibili.
Sistemi deterministici e sistemi probabilistici
Un programma tradizionale applica regole definite dal programmatore. A parità di ingresso e condizioni, produce normalmente lo stesso risultato.
Un modello generativo calcola distribuzioni di probabilità e può produrre risultati differenti. Anche quando viene impostato per ridurre la variabilità, non diventa automaticamente equivalente a un programma basato su regole rigide.
Questa differenza non implica che un sistema deterministico sia sempre corretto. Un programma può contenere errori. Tuttavia, un errore deterministico è generalmente riproducibile e può essere corretto modificando una regola precisa.
In un LLM, lo stesso errore può:
- apparire soltanto in alcune formulazioni;
- scomparire in un nuovo tentativo;
- essere sostituito da un errore differente;
- dipendere dal contesto;
- risultare difficile da isolare in una singola istruzione.
Errori tipici degli LLM
Gli errori più comuni comprendono:
- invenzione di fatti;
- citazioni inesistenti;
- collegamenti non verificati;
- confusione tra norme o documenti simili;
- sostituzione di nomi stabiliti;
- modifica di codice non richiesta;
- omissione di vincoli;
- produzione di codice sintatticamente valido ma logicamente errato;
- dichiarazione di test non eseguiti;
- eccessiva sicurezza;
- contraddizioni;
- interpretazione arbitraria di richieste letterali.
Il problema non è soltanto la frequenza media degli errori. È anche la difficoltà di prevedere quando si presenteranno.
Un sistema che funziona correttamente nove volte può essere inutilizzabile quando la decima risposta può modificare un file, una configurazione o un parametro critico senza autorizzazione.
Perché non usarli senza controllo
Gli LLM non dovrebbero essere utilizzati come unica fonte o unico decisore quando un errore può produrre conseguenze rilevanti.
Gli ambiti più sensibili comprendono:
- medicina;
- diritto;
- finanza;
- sicurezza informatica;
- impianti elettrici;
- automazione;
- controllo di macchine;
- configurazione di server;
- gestione di credenziali;
- dati scientifici;
- pubblicazione di informazioni tecniche;
- modifica diretta di file e infrastrutture.
In questi casi è necessaria una verifica indipendente.
Il controllo deve riguardare non soltanto il risultato finale, ma anche:
- dati utilizzati;
- fonti;
- istruzioni applicate;
- modifiche introdotte;
- operazioni realmente eseguite;
- possibilità di annullare l’intervento;
- registrazione degli errori.
Il NIST propone una gestione del rischio estesa a progettazione, sviluppo, distribuzione, uso e valutazione dei sistemi AI, invece di affidarsi alla sola qualità apparente dell’output.
Quando possono essere utili
I sistemi generativi possono essere utili quando il risultato è controllabile e l’errore è correggibile.
Esempi:
- prima bozza di un testo;
- riorganizzazione di appunti;
- confronto tra alternative;
- spiegazione preliminare;
- traduzione da revisionare;
- produzione di esempi;
- generazione di codice da verificare;
- sintesi di documenti controllabili;
- ricerca di possibili errori;
- ideazione di immagini;
- adattamento dello stile di un testo.
In questi compiti il modello riduce il tempo necessario per produrre una base di lavoro. Non sostituisce però il controllo sul contenuto.
Quando non devono decidere o agire autonomamente
L’uso diventa più rischioso quando il sistema può compiere azioni esterne.
Un errore in una bozza rimane nel testo. Un errore operativo può invece:
- cancellare file;
- modificare una configurazione;
- inviare un messaggio;
- pubblicare informazioni;
- cambiare permessi;
- arrestare un servizio;
- comandare un dispositivo;
- alterare dati;
- eseguire un pagamento;
- produrre una decisione sanitaria o amministrativa.
In questi casi l’autorizzazione dell’utente deve essere specifica e limitata all’operazione richiesta.
La possibilità tecnica di collegare un LLM a strumenti non implica che debba essere autorizzato ad agire senza controllo.
Il problema dell’antropomorfizzazione
Espressioni come “ha capito”, “sa”, “ricorda”, “vuole” o “ha deciso” sono comode nel linguaggio quotidiano, ma possono attribuire al sistema proprietà umane.
Un LLM può mantenere informazioni nel contesto, riprodurre una preferenza e descrivere le ragioni di una risposta. Questo non dimostra necessariamente che possieda consapevolezza, intenzione o comprensione umana.
L’antropomorfizzazione può produrre due errori opposti:
- fiducia eccessiva, perché il sistema appare competente e intenzionale;
- attribuzione morale impropria alla macchina, ignorando le responsabilità di chi la progetta e distribuisce.
Il comportamento del modello dipende da architettura, addestramento, dati, configurazione, strumenti concessi e decisioni organizzative.
Perché vengono distribuiti nonostante gli errori
Un sistema non deve essere perfetto per produrre valore commerciale.
Gli strumenti generativi possono:
- ridurre tempi di produzione;
- automatizzare parti del lavoro;
- aumentare l’uso di un servizio;
- generare ricavi;
- attirare investimenti;
- offrire vantaggio competitivo;
- raccogliere dati sul comportamento degli utenti;
- diventare componenti di altri prodotti.
Le aziende hanno quindi un incentivo a distribuire rapidamente modelli sempre più capaci.
Questo incentivo può entrare in conflitto con:
- tempi necessari per i test;
- trasparenza sui limiti;
- controllo dell’utente;
- possibilità di interrompere il servizio;
- costo delle correzioni;
- responsabilità per gli errori;
- valutazione degli impatti a lungo termine.
Non si può dedurre automaticamente che ogni azienda ignori la sicurezza. Si può però osservare che sviluppo, sicurezza e commercializzazione rispondono a incentivi differenti e non sempre perfettamente allineati.
Un prodotto può essere ritenuto economicamente vantaggioso anche se richiede agli utenti di verificare sistematicamente i risultati.
Le avvertenze non sostituiscono i vincoli tecnici
Una frase come “il sistema può commettere errori” informa l’utente, ma non impedisce l’errore.
Non equivale a:
- bloccare una modifica non autorizzata;
- impedire l’accesso a un file;
- richiedere una conferma specifica;
- conservare una versione precedente;
- registrare ogni operazione;
- distinguere ciò che è stato verificato da ciò che è stato generato;
- interrompere automaticamente un comportamento anomalo.
Quando il sistema può agire, la sicurezza deve essere incorporata nell’architettura operativa.
Devono esistere separazioni tra:
generazione
proposta
autorizzazione
esecuzione
verifica
Un modello può proporre una modifica. Un componente separato può controllare se essa rientra nel perimetro autorizzato. L’esecuzione può essere registrata e resa annullabile.
La responsabilità non appartiene soltanto all’utente
L’utente deve conoscere i limiti dello strumento e verificare i risultati importanti. Questo non significa che tutta la responsabilità possa essere trasferita su di lui.
La responsabilità riguarda anche:
- chi sviluppa il modello;
- chi seleziona i dati;
- chi progetta l’interfaccia;
- chi stabilisce le autorizzazioni;
- chi integra il modello in altri sistemi;
- chi decide quali errori siano accettabili;
- chi controlla gli incidenti;
- chi sceglie se mantenere il sistema operativo.
La sicurezza dipende quindi da decisioni tecniche, economiche, organizzative e normative.
LLM chiusi, open-weight e open source
Non tutti gli LLM sono distribuiti nello stesso modo.
I modelli chiusi sono accessibili attraverso un sito, un’applicazione o un’API. L’utente non riceve normalmente i pesi del modello e non può eseguirlo autonomamente.
Nei modelli open-weight vengono distribuiti i pesi, cioè i parametri numerici appresi durante l’addestramento. L’utente può scaricare il modello, compatibilmente con la licenza, ed eseguirlo su una propria macchina.
Il termine open source richiede maggiore precisione. L’Open Source AI Definition dell’Open Source Initiative considera necessarie libertà di uso, studio, modifica e condivisione, insieme alla disponibilità delle componenti necessarie per esercitarle. La sola pubblicazione dei pesi non rende necessariamente aperto l’intero sistema, perché possono mancare dati di addestramento, codice completo, configurazioni o libertà previste dalla licenza.
Occorre quindi distinguere tra:
modello chiuso
modello con pesi scaricabili
modello open-weight
modello con codice aperto
sistema AI più ampiamente open source
Le categorie possono sovrapporsi, ma non sono equivalenti.
Modelli scaricabili ed esecuzione locale
Alcuni LLM possono essere scaricati ed eseguiti su:
- computer personale;
- workstation;
- server locale;
- VPS dotata di risorse sufficienti;
- infrastruttura privata;
- dispositivi ad alte prestazioni.
I requisiti dipendono da:
- numero di parametri;
- precisione numerica;
- quantizzazione;
- lunghezza del contesto;
- velocità richiesta;
- numero di utenti;
- presenza di CPU, GPU o acceleratori.
La quantizzazione riduce la precisione con cui vengono conservati i pesi e permette di diminuire memoria e capacità di calcolo necessarie. Può però modificare prestazioni e qualità dell’output.
Alcuni produttori distribuiscono modelli scaricabili ed eseguibili localmente, mentre le licenze variano tra le diverse versioni.
Vantaggi dell’esecuzione locale
Un modello locale può offrire:
- maggiore controllo sulla versione;
- funzionamento senza dipendenza continua da un servizio remoto;
- possibilità di mantenere i dati nell’infrastruttura dell’utente;
- integrazione in applicazioni private;
- assenza di costo per singola richiesta;
- possibilità di modificare configurazione e parametri;
- maggiore indipendenza dal fornitore.
Questi vantaggi non eliminano automaticamente i rischi.
Un modello locale può ancora:
- inventare;
- produrre codice errato;
- ignorare istruzioni;
- generare contenuti incoerenti;
- esporre dati attraverso una configurazione sbagliata;
- utilizzare molte risorse;
- contenere vulnerabilità nelle librerie di esecuzione.
La gestione locale trasferisce inoltre sull’utente aggiornamenti, sicurezza, backup, controllo degli accessi e manutenzione.
Addestrare un LLM da zero
Addestrare un grande modello da zero significa inizializzare i parametri e modificarli attraverso enormi quantità di esempi.
Il processo richiede:
- grandi dataset;
- potenza di calcolo elevata;
- molte GPU o acceleratori;
- sistemi distribuiti;
- memoria;
- energia;
- tempo;
- tecnici specializzati;
- procedure di valutazione.
Non si tratta normalmente di un’operazione accessibile a un singolo utente.
La disponibilità dei pesi permette di utilizzare un modello già addestrato, non di riprodurre automaticamente il suo addestramento originale.
Fine-tuning
Il fine-tuning consiste nel proseguire l’addestramento di un modello preaddestrato utilizzando un dataset più piccolo e specifico.
Può servire per adattare il modello a:
- un settore tecnico;
- un formato;
- uno stile;
- una terminologia;
- una classificazione;
- un tipo di documento;
- una procedura conversazionale.
Il fine-tuning modifica i parametri del modello. Non equivale a inserire semplicemente documenti in un archivio da consultare.
Tecniche di adattamento più leggere
Non è sempre necessario modificare tutti i pesi.
Tecniche di adattamento efficienti possono addestrare soltanto una piccola parte dei parametri o aggiungere componenti separati, chiamati adattatori.
Questo riduce:
- memoria necessaria;
- tempo di addestramento;
- spazio per salvare ogni variante;
- costo computazionale.
Tali tecniche rendono possibile personalizzare modelli anche con risorse inferiori rispetto a un fine-tuning completo.
Non garantiscono però che il modello rispetti sempre il comportamento appreso. Rendono alcune risposte più probabili, non trasformano il sistema in un insieme rigido di regole.
Fine-tuning e conoscenza documentale non sono la stessa cosa
Addestrare un modello su documenti specifici non garantisce che esso riproduca sempre correttamente ogni informazione contenuta.
Il fine-tuning è più adatto a modificare:
- stile;
- formato;
- comportamento;
- specializzazione;
- capacità su un compito.
Quando è necessario recuperare informazioni precise e aggiornabili, può essere più adatto collegare il modello a un archivio documentale e fornirgli i passaggi pertinenti al momento della risposta.
Anche in questo caso la fonte deve essere controllata e la risposta deve rimanere verificabile.
Licenze e limiti d’uso
Un modello scaricabile non è automaticamente utilizzabile per qualunque scopo.
La licenza può stabilire:
- usi consentiti;
- usi vietati;
- condizioni commerciali;
- obblighi di attribuzione;
- limiti alla redistribuzione;
- condizioni per le versioni modificate;
- restrizioni legate alle dimensioni dell’organizzazione;
- obblighi di pubblicazione.
Prima di scaricare, modificare o integrare un modello occorre verificare la licenza della versione precisa utilizzata.
Un modello locale non diventa deterministico
Il controllo sull’infrastruttura non cambia la natura fondamentale del modello.
Un LLM locale rimane un generatore probabilistico. Può essere configurato per ridurre la variabilità, ma può ancora:
- produrre risposte differenti;
- confondere istruzioni;
- inventare;
- utilizzare schemi sbagliati;
- richiedere verifica.
Il vantaggio dell’esecuzione locale riguarda controllo, riservatezza, disponibilità e integrazione. Non costituisce una garanzia di correttezza.
Valutare l’AI per funzione e rischio
Non è utile chiedere genericamente se “l’AI funziona”.
Occorre chiedere:
- quale sistema;
- per quale compito;
- con quali dati;
- con quale margine di errore;
- con quali verifiche;
- con quali autorizzazioni;
- con quali conseguenze;
- sotto la responsabilità di chi.
Un generatore di immagini può essere adeguato per un’illustrazione dichiaratamente artificiale e inadatto per uno schema elettrico.
Un LLM può essere adeguato per proporre una bozza e inadatto per modificare autonomamente una configurazione di sicurezza.
Un classificatore può essere utile per segnalare casi sospetti e inadeguato per assumere da solo una decisione irreversibile.
Conclusioni
“Intelligenza artificiale” è un termine generale che comprende tecnologie differenti. Gli LLM generano testo, i modelli di diffusione generano immagini, altri sistemi classificano, prevedono o ottimizzano.
Un risultato convincente non dimostra comprensione, verità o affidabilità. Gli LLM possono inventare informazioni, confondere strutture simili, non rispettare vincoli e affermare di avere eseguito controlli inesistenti. I generatori di immagini possono modificare elementi non richiesti e produrre composizioni visivamente credibili ma tecnicamente errate.
Questi strumenti possono essere utili quando l’output viene controllato e l’errore è reversibile. Non devono essere trattati come sistemi deterministici o autonomamente affidabili nei compiti critici.
Esistono modelli chiusi, open-weight e sistemi più ampiamente aperti. Alcuni LLM possono essere scaricati, eseguiti localmente e adattati mediante fine-tuning. Questo aumenta il controllo dell’utente, ma non elimina confabulazioni, incoerenze o mancato rispetto delle istruzioni.
La valutazione corretta non consiste quindi nel decidere se l’AI sia buona o cattiva in generale. Consiste nello stabilire quale tecnologia viene utilizzata, quale funzione svolge, quali errori può produrre, chi li controlla e quali conseguenze possono derivarne.
Fonti principali
Vaswani, A. et al. — Attention Is All You Need, 2017
Ho, J., Jain, A. e Abbeel, P. — Denoising Diffusion Probabilistic Models, 2020
Nichol, A. e Dhariwal, P. — Improved Denoising Diffusion Probabilistic Models, 2021
National Institute of Standards and Technology — Artificial Intelligence Risk Management Framework 1.0
National Institute of Standards and Technology — Generative Artificial Intelligence Profile
Open Source Initiative — Open Source AI Definition
Hugging Face — Documentazione sul fine-tuning dei modelli Transformers
Mistral AI — Modelli aperti, licenze ed esecuzione locale
Meta — Licenza dei modelli Llama